

COLUMNコラム
RAG(検索拡張生成)とは? 活用するメリットや活用例を解説
RAG(検索拡張生成)とは生成AIが回答を生成する前に、事前に用意しておいた外部情報を参照させる手法です。
たとえば、生成AIに自分がすでに熟知している内容について質問をしたら、明らかに間違った回答が返ってきた、ということはないでしょうか? このようなハルシネーションを、RAGは外部情報で補足することで低減できます。
本記事では、RAGの仕組みや活用例について解説します。Web検索だけでなく、業務でもAI活用が広がり、AIが正確な情報を参照する仕組み作りが注目を集めています。RAGの活用をお考えの方は、ぜひ参考にしてみてください。
RAG(検索拡張生成)とは?
RAGとはどのような手法なのでしょうか。ここでは、RAGが注目される背景や関連技術、一般的な活用について解説します。
通常のAI回答との違い
RAGは回答を生成する前に、参照できる外部情報を用意することで回答精度を高める手法です。通常のAI回答と工程を比較すると次のようになります。
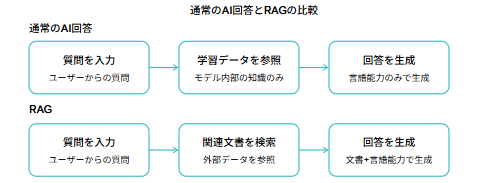
通常のAI回答では、LLMが学習済みの知識をもとに回答を生成します。一方、RAGでは回答に必要な情報を外部から取得し、その情報をLLMに参照させて回答を生成します。
そのためRAGでは、LLMが持っていない情報や、社内文書などの特定の情報を回答に活用することが可能です。また、参照する情報があらかじめ用意されているため、回答の根拠を確認しやすいという特徴もあります。
注目される背景
RAGが注目を集めているのは、LLM(大規模言語モデル)の課題であったハルシネーションを軽減し、AIを実務で活用しやすくできる点にあります。
LLMは学習データにない質問をされると、推測で事実に基づかない回答を生成してしまうことがあります。このような現象は「ハルシネーション」と呼ばれ、AIを業務で活用する上での大きな課題になっています。
このハルシネーションを、外部情報を用意することで補えるのがRAGです。
たとえば、社員が生成AIに「有給休暇は何日取得できますか?」と質問したとします。会社の「就業規則」「休暇規程」などは、一般に社内向けの情報です。Web上で公開されている情報を参考にする一般検索では、ユーザーが意図した通りの回答は期待できません。
一方、RAGなら、外部情報として用意した社内文書から質問に関連する情報を取得し、その内容をもとに生成AIが回答を生成できます。文書に情報があれば、「入社2年目の場合は?」「パートの場合は?」といった個別の事情にも対応が可能です。
RAGを導入することで、AI回答は、これまで以上に正確で、業務に活用しやすいものになります。
ファインチューニングとの違い
RAGと同様に、LLMが学習していないデータを活用して、回答の生成に役立てる手法として、ファインチューニングがあります。ファインチューニングとは、既存のLLMに追加のデータを学習させ、LLM自体を特定の用途や分野に適応させる方法です。
両者は、ユーザーにとって適切な回答を生成するという大きな目的では一致していますが、得意分野や仕組みは異なります。
| 比較項目 | RAG | ファインチューニング |
|---|---|---|
| 知識の反映方法 | モデルは変えず、回答時に外部情報を参照させる | モデル自体に追加のデータを学習させる |
| 情報の更新 | 文書を差し替える | 追加データでLLMを再学習 |
| 出典の提示 | 根拠となる文書を示しやすい | 学習した情報の出典を直接示すのは難しい |
| ハルシネーション対策 | 根拠となる情報を参照させることで軽減できる | 学習させても誤答が残る可能性がある |
| 導入の難易度・コスト | 比較的低く、導入しやすい | 比較的に高く、学習データの準備と学習処理が必要 |
| 得意分野 | 最新情報や大量の文書への対応 | 口調・文体や特定のタスクへの適応 |
両者の大きな違いは、RAGが既存のLLMと外部情報を組み合わせて回答するのに対し、ファインチューニングはLLM自体に追加データを学習させる点にあります。
RAGは外部情報として用意したデータを更新すれば、最新情報を反映できます。一方、ファインチューニングでは、追加したい情報や学習内容に応じてLLMの再学習が必要です。そのため、情報更新を頻繁に行う用途では、RAGのほうが扱いやすい傾向があります。
どちらもLLMの学習データにはない情報を活用できる仕組みですが、現在は、最新情報や社内データなどを参照して回答させたい場合はRAG、特定のタスクや出力形式にLLMを適応させたい場合はファインチューニングといったように、得意分野によって使い分けられるようになっています。
社内ナレッジの共有や問い合わせ対応の手法として普及
RAGは主に、社内規定や業務情報の共有、製品情報・FAQを使った問い合わせ対応の効率化などに利用されています。
たとえば、三井住友銀行は社内AIツール「SMBC-GAI」にRAGを追加し、約130万件の社内文書を検索・回答生成に対応させていました。朝日生命、JR東日本など複数の大手企業も同様に、社内向けの生成AIチャットツールにRAGを導入しています
参照URL
三井住友銀行:SMBCグループ独自AI「SMBC-GAI」、社内文書ファイルを横断検索へ
朝日生命:生成 AI を活用した照会回答システムを導入
JR東日本:生成 AI チャットの全社員展開及び生成 AI の内製開発について
社外向けの利用では、東京メトロが、公式WEBサイトの情報をもとに回答を生成する生成AI搭載のチャットボットを導入しています。プレスリリースにこそRAGの表記はありませんが、同じく外部情報を参照して回答を生成する仕組みです。
参照URL
東京メトロ:鉄道会社初! 生成AI搭載のチャットボットが、お客様のお問合せに対応します! 合わせて、お客様センターの業務にも生成AIを活用します!
このように、社内の情報共有から顧客対応まで、RAGを前提に業務や情報発信の仕組みを設計する企業が増えています。今後は、情報を「人が探す」のではなく「AIが探して答える」ことを前提に、社内文書やWebサイトを整備していく流れが広がっていくと考えられます。
RAGを活用するメリット
RAGは大企業を中心に、世界中で導入が進んでいます。企業はRAGのどのような点を評価しているのでしょうか? ここでは、そのメリットを整理します。
ハルシネーションを軽減できる
RAGは、LLMが回答を生成する前に、あらかじめ用意した外部情報を参照させる仕組みです。LLMが持つ知識だけに頼らず、外部情報で不足を補うことで、学習データにない質問に対する的外れな推測を減らせます。
社内規定や業務マニュアル、製品情報のように、正確さが欠かせない情報を扱う場面では、誤ったAI回答がそのまま業務トラブルにつながりかねません。この「AIの回答を信頼できるか」という不安から、活用に踏み切れない企業も少なくありませんでした。
RAGが評価されているのは、回答の根拠となる情報を、企業自身が用意し管理できる点です。何を参照させるかを自社でコントロールできるため、正確さが求められる業務でも、ハルシネーションを抑えながら生成AIを活用しやすくなっています。
最新情報を反映しやすい
RAGでは、外部情報を参照させてからLLMが回答を生成します。そのため、外部情報を更新すれば、LLMを再学習させなくても最新情報を回答に反映できます。
企業が扱う情報の中には、頻繁に更新される内容も少なくありません。一方で、RAGは情報更新のたびにLLMを再学習させる必要がなく、外部情報を差し替えるだけで、AI回答を最新状態に保てます。比較的手間をかけずに最新情報を反映できる点も、RAGの強みです。
社内ナレッジを管理・活用しやすい
RAGの外部情報は、LLM本体とは分離されたデータベースに保管されます。回答の際に必要な情報だけを参照する仕組みなので、ファインチューニングなどと比較して、機密情報を含むデータを管理しやすい側面があります。
LLMは、学習データから身につけたパターンをもとに回答を生成するため、回答時に参照する情報を直接指定することはできません。一方で、RAGでは参照させる情報とそのアクセス範囲を人間側である程度コントロールできます。情報の制御・管理のしやすく、リスク対策を取りやすいのもRAGのメリットです。
AIの学習・更新にかかるコストを抑えられる
RAGは、外部情報を用意し、既存のLLMを補助する形式です。再学習が不要なため、コストを抑えられる傾向があります。
AIを業務で活用するには、LLMが参照する情報を常に最新の状態に保つことが大切です。しかし、ファインチューニングのようにLLMを再学習させる手法では、情報を更新するたびに学習処理をやり直す必要があります。学習データの準備や大規模なコンピューター処理が必要になるため、更新のたびに一定のコストがかかります。
一方、RAGは大掛かりな作業を必要としません。テキストなどの外部情報を更新するだけで、最新状態を保てます。再学習と比較して維持・管理のコストを抑えやすいのも、導入が広まっている理由です。
RAGの活用例
RAGは従来にはないメリットがあることで、AI活用の幅を広げています。ここでは、代表的なRAGの活用例について解説します。
FAQ・問い合わせへの対応
RAGを活用すると、FAQやマニュアルなどを参照しながら、ユーザーの質問に応じた回答を生成できるようになります。あらかじめ用意した情報をもとに回答できるため、問い合わせ対応の効率化につながります。
従来のFAQでは、ユーザーが質問と回答の一覧から、必要な情報を自分で探さなくてはなりませんでした。また、質問の表現がFAQに登録されている内容と異なると、適切な回答を見つけられない場合もありました。
RAGを組み込むと、ユーザーが自然な文章で質問した場合でも、関連する情報を検索して回答を生成できます。たとえば、「購入した商品を交換したい」「返品するにはどうすればいい?」といった質問に対して、返品・交換に関する規定をもとに回答する、といった使い方ができます。
情報検索システムの改善
RAGを活用すると、社内文書やマニュアルなど、蓄積された情報から質問に関連する内容を検索し、その情報をもとに回答を生成できます。必要な情報を探すだけでなく、内容を整理して回答できるため、情報検索の効率化につながります。
従来の情報検索システムでは、検索結果として表示された文書やページをユーザー自身が確認し、必要な情報を探す必要がありました。文書が多い場合や、複数の資料に情報が分散している場合は、目的の情報を見つけるまでに時間がかかることがありました。
RAGを導入すると、たとえば「新入社員が経費精算するときの手順を教えて」と質問するだけで、関連する社内規定やマニュアルから必要な情報を取得し、手順を整理して回答できます。複数の文書を横断して情報を探す必要がある場面でも、求める情報を効率的に確認しやすくなります。
製品・サービス情報の案内
RAGを活用すると、製品やサービスに関する情報を参照しながら、ユーザーの質問に応じた回答を生成できます。商品情報や料金、利用方法などをもとに案内できるため、顧客への情報提供を効率化できます。
従来は、商品ページやFAQなどをユーザー自身が確認したり、問い合わせ窓口に質問したりする必要がありました。情報が複数のページに分かれている場合、必要な情報を見つけるまでに時間がかかることもあります。
RAGを導入すると、たとえば「この商品の返品期限は?」「このサービスは法人でも利用できますか?」といった質問に対して、関連する製品情報や利用規約などを検索し、その内容をもとに回答できます。最新の製品情報やサービス内容を外部情報として更新しておけば、変更された情報も回答に反映しやすくなります。
技術文章やコンテンツの生成
RAGを活用すると、あらかじめ用意した技術資料や製品情報などを参照しながら、目的に応じた文章を生成できます。既存の情報をもとに文章を作成できるため、コンテンツ制作や文書作成の効率化につながります。
従来は、担当者が複数の資料を確認し、必要な情報を整理したうえで文章を作成する必要がありました。特に専門的な内容では、正確性を確認しながら文章を作成するため、時間や手間がかかります。
RAGを導入すると、たとえば製品仕様書や技術資料を参照して、製品の説明文やマニュアル、FAQなどを生成できます。既存の資料を回答の根拠として利用できるため、情報を確認しながら文章作成を効率化しやすくなります。
RAG活用の注意点
活用例から分かるように、RAGは企業が蓄積した情報をAIに活用させることで、情報を探す・伝える・文章にまとめるといった業務を効率化できます。一方でRAGの応答品質は、AIが参照する外部情報や管理方法によって大きく左右されます。最後に、RAGを活用する際の注意点を解説します。
外部情報となるデータの品質
RAGでは、LLMが参照する外部情報の内容が、回答の品質に影響します。誤った情報や古い情報を登録すると、それをもとにAIが回答を生成するため、正確な回答は得られなくなる可能性があります。
そのため、RAGに登録する情報は、正確性や最新性を確認したうえで、不要になった情報を整理することが欠かせません。情報の追加・更新・削除を行う運用ルールや担当者を決めおくなど、情報鮮度と正確性を保つ仕組みを作っておきましょう。
チャンクの分け方
RAGでは、外部情報をそのまま一つの文書として扱うのではなく、検索しやすい大きさのまとまり(チャンク)に分けて保存することがあります。 チャンクの分け方によって、質問に関連する情報を適切に取得できるかどうかが変わるため、回答の品質にも影響します。
そのため、文章の内容や意味のまとまりを考慮し、適切な単位でチャンクに分けることが大切です。基本としては「複数の話題が混ざった長文は、質問に関連した部分を見つけにくくなるので、話題ごとに区切る」「短く区切りすぎると、質問に回答するための情報が分散しやすくなるので、意味が通る単位で区切る」といった点を意識します。想定されるユーザーの質問に対して「チャンク単位で適切な回答を生成できるか?」に着目しましょう。
機密情報の取り扱い
社内情報を活用・管理しやすいのがRAGのメリットですが、その中には社内文書や顧客データといった機密性の高い内容も含まれます。セキュリティ確保は重要な課題の一つです。
代表的なセキュリティ対策として、登録情報の選定やアクセス権限の設定、監査ログの定期的な確認などがあります。情報漏洩などのリスクを抑える仕組みを整え、利用するAIサービスのセキュリティ機能やデータの取り扱いについても、事前に確認しておきましょう。
継続的な情報更新
RAGの外部情報は、AIの学習データのように自動更新されることはありません。情報が古いと、AIも古い情報を元に回答する可能性があります。
そのため、参照する情報を定期的に確認し、変更があった場合はRAG側のデータも更新することが大切です。 更新する頻度や担当者、古くなった情報の扱いなどをあらかじめ決めておくと、情報を最新の状態に保ちやすくなります。情報鮮度を保つ仕組みを作っておきましょう。
まとめ
外部情報を参照することでLLMを再学習させずに最新情報を活用できるのが、RAGの特徴です。これにより、業務における生成AIの実用性が高まり、企業でもAI活用が普及しつつあります。
これからは、業務効率化だけでなく、コンテンツ制作を含む、さまざまな分野でRAGの活用が広まると予想されます。今後もその動向に注目していきましょう。